
llms.txt et robots.txt : à quoi ils servent, et les modifier sans FTP
Ce qu'est le fichier llms.txt, ce que règle robots.txt, les erreurs courantes, et comment les modifier depuis le back-office CodeMyShop, sans FTP.
Le blocage technique des fichiers robots.txt et llms.txt en e-commerce sans accès serveur
Dans la gestion quotidienne d'une boutique en ligne, le contrôle des accès accordés aux moteurs de recherche et aux nouveaux systèmes d'exploration représente un enjeu opérationnel déterminant. Historiquement, la configuration du fichier robots.txt exigeait une intervention directe sur l'infrastructure d'hébergement. Pour un marchand exploitant une boutique en ligne B2B ou B2C, la moindre modification d'une règle d'exploration impliquait souvent l'utilisation d'un accès par transfert de fichiers (FTP ou SFTP), l'ouverture d'un accès sécurisé en ligne de commande (SSH), ou la création d'un ticket auprès d'une équipe technique pour modifier le référentiel de code source. Cette dépendance technique introduit une friction inutile pour les équipes chargées du référencement et du catalogue, ralentissant des ajustements qui devraient être immédiats face aux comportements des robots d'indexation.
Le fichier robots.txt sert de premier point de contact pour les robots d'indexation classiques des moteurs de recherche. Situé à la racine du domaine, il fournit des instructions normalisées pour indiquer les sections du site dont l'exploration est autorisée ou restreinte. Lorsqu'un robot parcourt une boutique comportant des milliers de fiches, des facettes de navigation, des pages de panier ou des résultats de recherche interne, une directive d'exclusion permet de préserver les ressources serveur et d'orienter les robots vers les contenus à forte valeur ajoutée. Toutefois, la manipulation manuelle de ce fichier comporte des risques élevés lorsqu'elle est réalisée sans contrôle rigoureux. De nombreux marchands constatent des baisses d'audience consécutives à des erreurs de syntaxe évitables.
Parmi les erreurs courantes rencontrées dans la rédaction d'un fichier robots.txt, on relève fréquemment :
- Le blocage involontaire des ressources statiques indispensables au rendu des pages, telles que les feuilles de style CSS et les scripts JavaScript, ce qui empêche les moteurs d'évaluer la mise en page mobile et la conformité visuelle du site.
- L'application de directives d'interdiction trop larges, par exemple une règle
Disallow: /oubliée après une phase de test ou de préproduction, qui bloque l'intégralité du catalogue public aux robots d'exploration. - La confusion dans la hiérarchie et l'ordre des règles
AllowetDisallow, créant des conflits d'interprétation selon les normes des différents agents utilisateurs (user-agents). - L'absence de déclaration ou la présence d'adresses erronées pointant vers les fichiers de sitemap XML, privant les moteurs d'un index clair de l'arborescence.
- La tentative erronée d'utiliser le
robots.txtpour masquer des pages confidentielles ou sécurisées, alors que ce fichier est public et ne remplace en aucun cas une authentification robuste.
À ces problématiques traditionnelles s'ajoute l'émergence rapide d'un second fichier : le llms.txt. Alors que le robots.txt régule l'exploration technique des pages HTML pour les moteurs traditionnels, le llms.txt est une proposition de format textuel en Markdown destiné aux assistants IA et aux modèles de langage. Il leur fournit une description synthétique, claire et structurée du site, de son catalogue et de ses ressources documentaires, facilitant la sélection d'informations précises sans consommer inutilement des jetons de contexte. Dans le cadre d'un pipeline SEO automatisé moderne, devoir manipuler ces deux fichiers via des outils de transfert de fichiers archaïques constitue un frein majeur pour les marchands qui souhaitent piloter leur présence en ligne de manière réactive.
Qu'est-ce que le fichier llms.txt ?
Le llms.txt est une proposition publiée en septembre 2024 par Jeremy Howard (Answer.AI), documentée sur llmstxt.org. L'idée est simple : un modèle de langage lit mal une page HTML chargée de menus, de scripts et de blocs promotionnels, et sa fenêtre de contexte est limitée. Le site lui offre donc, à une adresse connue, un résumé en Markdown qui pointe vers ses pages essentielles.
Le fichier se place à la racine du domaine, à l'adresse /llms.txt. La proposition en fixe la forme :
- un titre de niveau 1 portant le nom du site ou du projet — le seul élément obligatoire ;
- une citation (ligne commençant par
>) qui résume le site en quelques phrases ; - des paragraphes libres, si un contexte supplémentaire est utile ;
- des sections de niveau 2 contenant des listes de liens, chacun suivi d'une courte description ;
- une section intitulée « Optional » pour les liens qu'un assistant peut ignorer quand la place lui manque.
Pour une boutique, un exemple minimal ressemble à ceci :
# Nom de la boutique

> Vente en ligne de matériel de cuisine professionnel, livraison en France et en Belgique.

## Catalogue
- [Couteaux](https://exemple.fr/couteaux): gammes, aciers et entretien
- [Casseroles](https://exemple.fr/casseroles): inox, cuivre, induction

## Informations
- [Livraison et retours](https://exemple.fr/livraison): délais et conditions
- [Contact](https://exemple.fr/contact)

## Optional
- [Blog](https://exemple.fr/blog)
Deux précisions honnêtes. D'abord, llms.txt n'est pas un standard : c'est une proposition, sans valeur normative comparable à celle du robots.txt. Il n'interdit rien à personne — il décrit, il ne bloque pas. Ensuite, aucun grand moteur de recherche ni aucun assistant n'a promis publiquement de le lire systématiquement. C'est un effort de lisibilité peu coûteux, pas un levier de classement garanti. C'est justement parce qu'il coûte peu qu'il vaut la peine de pouvoir l'écrire et le corriger soi-même, sans passer par un développeur.
La gestion directe des directives d'exploration dans CodeMyShop : fichiers SEO et sitemaps
Pour répondre à cette contrainte d'exploitation, CodeMyShop intègre une gestion centralisée des directives d'indexation directement accessible depuis son interface d'administration. CodeMyShop est un PaaS e-commerce open source, distribué sous licence AGPL-3.0, présenté comme souverain et européen, et conçu en France. Bâti sur une stack 100 % TypeScript articulée autour de Nuxt 4, Drizzle et PostgreSQL, avec IA intégrée, il applique une politique stricte de 0 % de commission sur les ventes. Dans cette architecture conçue par Alexandre Carette, l'objectif est d'offrir une autonomie opérationnelle totale aux commerçants et aux développeurs qui déploient la solution, en éliminant les intermédiaires techniques superflus.
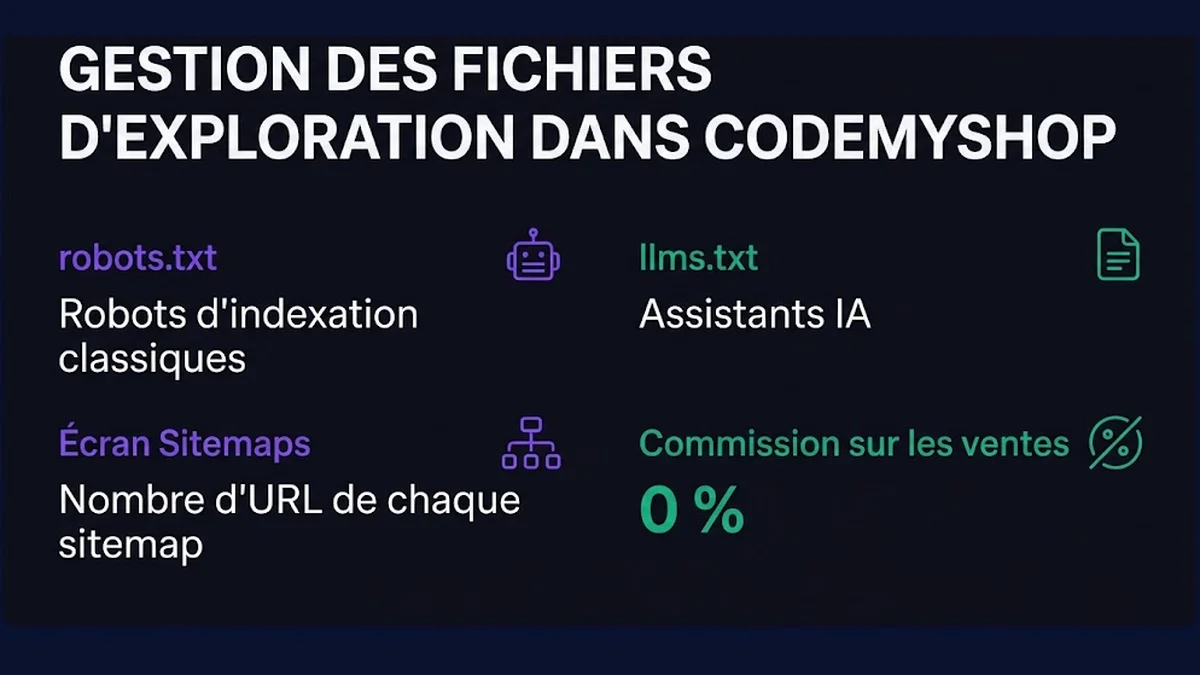
Au sein de la plateforme, les fonctionnalités dédiées au référencement permettent de visualiser et d'éditer les fichiers d'exploration sans jamais ouvrir de client FTP ni modifier de conteneur d'hébergement. Deux composants principaux structurent ce dispositif dans la console SEO du hub :
- L'écran « Fichiers SEO », qui permet de modifier directement le contenu des fichiers
robots.txtetllms.txtdepuis le navigateur. Le contenu enregistré est ensuite servi aux robots et agents qui interrogent les URLs respectives à la racine du domaine. - L'écran Sitemaps, qui affiche le nombre d'URL de chaque sitemap généré par la plateforme, accompagné d'un lien direct vers chaque fichier XML pour en faciliter la vérification manuelle et le suivi.
La distinction entre ces deux fichiers répond à des cibles techniques complémentaires dans l'écosystème e-commerce actuel. Les robots d'indexation classiques parcourent les balises HTML, analysent les liens hypertextes et construisent les index des moteurs de recherche conventionnels. En parallèle, les assistants IA qui consultent le fichier llms.txt y trouvent les pages de référence et une description de l'offre, sans avoir à reconstituer la structure du site page après page. Cette complémentarité s'inscrit pleinement dans la démarche de l'optimisation pour l'intelligence artificielle, où la lisibilité technique et la clarté sémantique opèrent conjointement.
| Élément | Destinataires principaux | Format de données | Écran de gestion dans CodeMyShop | Rôle opérationnel |
|---|---|---|---|---|
| robots.txt | Robots d'indexation classiques | Texte brut normalisé (directives d'exploration) | Écran « Fichiers SEO » | Réguler et restreindre l'accès aux répertoires et ressources du site |
| llms.txt | Assistants IA et modèles de langage | Markdown structuré | Écran « Fichiers SEO » | Fournir un contexte synthétique et des liens clés aux systèmes génératifs |
| Sitemaps XML | Moteurs de recherche et explorateurs | Fichiers XML hiérarchiques | Écran Sitemaps | Lister les URLs disponibles et afficher le nombre d'URL de chaque sitemap |
Il convient de souligner que cette fonctionnalité d'édition directe est incluse dans les offres hébergées de CodeMyShop (niveau Pro et au-delà). Elle apporte une couche de gouvernance visuelle qui dispense l'équipe e-commerce de manipulations système à chaque ajustement d'exploration, tout en conservant la rigueur d'une infrastructure moderne.
Navigation dans la console SEO du hub : écran Fichiers SEO et écran Sitemaps
L'accès aux outils de configuration SEO s'effectue directement dans l'interface de gestion de la boutique. Au sein de la console SEO du hub, l'utilisateur dispose d'un espace centralisé pour surveiller et ajuster ses fichiers de référence. L'architecture sépare nettement l'édition textuelle des règles de découverte de la visualisation des flux XML.
L'écran « Fichiers SEO »
L'écran « Fichiers SEO » est dédié à la consultation et à la modification directe des deux fichiers stratégiques que sont robots.txt et llms.txt. Depuis cet écran, le gestionnaire du site peut intervenir sur le texte brut du fichier robots.txt pour ajouter des exclusions sur des paramètres d'URL spécifiques, autoriser l'exploration de répertoires récents ou déclarer l'emplacement canonique de ses sitemaps. De la même manière, le fichier llms.txt peut être ajusté pour refléter les évolutions majeures du catalogue ou orienter les assistants IA vers les guides de choix prioritaires de l'entreprise.
À retenir : La modification directe de robots.txt et llms.txt depuis le back-office évite de passer par le serveur, mais exige une relecture méthodique de chaque règle afin de ne pas restreindre l'accès aux ressources nécessaires au rendu.
Avant d'enregistrer des modifications dans l'écran « Fichiers SEO », une démarche méthodique s'impose pour éviter toute rupture d'indexation :
- Vérifier la casse et l'orthographe exacte des chemins indiqués, les systèmes de fichiers et les robots d'exploration respectant strictement la sensibilité aux majuscules et minuscules.
- Conserver systématiquement l'accès libre aux répertoires contenant les polices de caractères, les styles CSS et les bibliothèques JavaScript nécessaires à l'affichage fidèle des pages.
- Contrôler que les sections administratives, les comptes clients et les tunnels de commande comportent bien les exclusions nécessaires pour éviter l'exploration de contenus sous session.
- Structurer le fichier
llms.txtavec des descriptions concises et factuelles des grandes gammes de l'entreprise, sans jargon commercial ni liens rompus.
L'écran Sitemaps
Complémentaire de l'écran « Fichiers SEO », l'écran Sitemaps assure le suivi volumétrique de l'arborescence déclarée aux moteurs. Il affiche le nombre d'URL de chaque sitemap généré par la plateforme, qu'il s'agisse des sitemaps dédiés aux fiches produits, aux catégories de navigation ou aux pages éditoriales. Un lien direct vers chaque fichier XML permet à l'équipe de cliquer sur le flux pour inspecter sa structure dans le navigateur, contrôler la conformité des balises de date et s'assurer que le nombre d'URL correspond bien à l'état réel du catalogue actif en base de données PostgreSQL.
Pour qui c'est fait, et pour qui ça ne l'est pas
La simplification de la gestion de robots.txt et llms.txt répond à des exigences organisationnelles précises, mais son utilité varie selon la maturité technique et la structure des équipes qui exploitent la boutique.
Les profils pour lesquels cette fonctionnalité est conçue
Cette approche est particulièrement adaptée aux profils suivants :
- Les marchands B2B et B2C indépendants : Les dirigeants de PME et responsables e-commerce qui pilotent leur boutique sans développeur dédié à plein temps trouvent ici le moyen d'intervenir en direct sur leurs directives SEO sans souscrire de support externe ni dépendre d'une intervention système.
- Les équipes marketing et SEO internes : Les référenceurs ont besoin d'ajuster rapidement les règles d'exploration lors du lancement d'une nouvelle structure d'URL ou pour isoler temporairement des filtres facettés provoquant un gaspillage de ressources d'exploration. L'accès via la console SEO du hub fluidifie leur cycle de travail.
- Les développeurs déployant CodeMyShop en production : Les développeurs apprécient de décharger l'équipe technique des requêtes récurrentes liées à l'édition de fichiers textuels basiques, tout en s'appuyant sur une architecture Nuxt 4 et Drizzle maîtrisée, dans la continuité d'une architecture e-commerce headless performante.
Les situations où elle n'est pas recommandée
À l'inverse, l'édition directe en back-office n'est pas adaptée à tous les contextes de gouvernance :
- Les structures imposant un flux de validation Git obligatoire : Certaines directions techniques exigent que chaque modification apportée à un fichier servi en production fasse l'objet d'une branche Git, d'une revue de code par les pairs et d'un historique de commits tracé. Pour ces organisations, une modification réalisée depuis une interface d'administration peut court-circuiter le protocole de déploiement continu.
- Les organisations dépourvues de compétences de base en référencement : Une mauvaise directive dans
robots.txtpeut bloquer l'exploration de sections entières du site. En l'absence d'une personne comprenant la portée des directivesDisallow, une interface sans restriction peut devenir une source d'erreurs involontaires. - Les installations sur l'édition auto-hébergée sans abonnement managé : La fonctionnalité d'édition directe étant incluse dans les offres hébergées de CodeMyShop (niveau Pro et au-delà), c'est dans ce cadre qu'elle est proposée.
Dans un contexte de reprise en main de ses actifs numériques, comprendre l'équilibre entre souplesse d'administration et rigueur technique permet aux marchands d'assurer leur indépendance vis-à-vis des intermédiaires qui contrôlent l'e-commerce.
Ses limites actuelles, dites franchement
Adopter une posture d'expertise impose de décrire les limites réelles du système, sans promesses disproportionnées ni allégations techniques non vérifiables.
En premier lieu, l'écran « Fichiers SEO » permet de modifier directement robots.txt et llms.txt, mais il ne constitue pas un simulateur d'exploration. L'interface prend le texte saisi par l'utilisateur et le sert tel quel à l'adresse requise. Si l'administrateur commet une erreur de frappe dans un nom de user-agent ou formule une directive contradictoire, le système n'effectue pas de validation sémantique préalable. La responsabilité de la logique syntaxique repose entièrement sur la personne qui édite le contenu.
En second lieu, il est essentiel de rappeler qu'aucune modification de robots.txt ou de llms.txt ne garantit un effet positif ou immédiat sur le classement des pages dans les moteurs de recherche. Le robots.txt indique uniquement aux robots ce qu'ils ont le droit d'explorer ; il ne dicte ni l'indexation finale, ni la pertinence algorithmique, ni le positionnement d'une requête commerciale. De même, les moteurs de recherche peuvent choisir d'indexer une URL sans en explorer le contenu si des liens externes pointent vers elle. Concernant llms.txt, les assistants IA et modèles de langage restent libres d'exploiter ou d'ignorer ce fichier en fonction de leurs propres stratégies de collecte et d'entraînement.
Enfin, l'écran Sitemaps affiche le nombre d'URL de chaque sitemap avec un lien vers chaque fichier XML, mais il ne s'agit pas d'un outil d'audit de santé des liens. Cet écran présente un décompte quantitatif et un accès direct aux fichiers générés, mais il n'identifie pas les codes de réponse HTTP (redirections 301, erreurs 404) au sein de chaque URL répertoriée. Pour analyser la validité technique de chaque lien déclaré, le marchand devra recourir aux outils d'analyse habituels ou aux consoles des moteurs de recherche.
En synthèse, la console SEO du hub de CodeMyShop apporte une réponse concrète à un besoin d'autonomie bien identifié : modifier rapidement les règles d'exploration sans dépendre d'un transfert FTP ou d'un redéploiement d'infrastructure. Pour découvrir la plateforme et mettre en place votre boutique, vous pouvez accéder directement à la page https://codemyshop.com/onboarding pour démarrer.
À lire aussi
Questions fréquentes
Tout ce que vous devez savoir sur ce sujet.
Une question ?
Contactez-nous directement.
Discussion
Nos conseils liés à Fonctionnalités
 Fonctionnalités
Prise de rendez-vous intégrée à la boutique | CodeMyShop
Découvrez la prise de rendez-vous intégrée de CodeMyShop : réservation sur la vitrine, gestion dans le hub, confirmation par e-mail et lien avec le CRM.
 Fonctionnalités
Serveur MCP CodeMyShop : brancher son IA sur sa boutique
Connectez votre assistant IA à votre boutique CodeMyShop via le serveur MCP en bêta. Analyse des ventes, gestion des stocks et optimisation SEO sécurisée.